

KI-Erkennung im Literaturüberblick: echter Test mit geprüften Zitaten
Wir haben einen KI-entworfenen Absatz aus einem Literaturüberblick durch Humanizer v2 geschickt. Alle Zitate blieben intakt. Manche der damit verbundenen Aussagen verschoben sich.
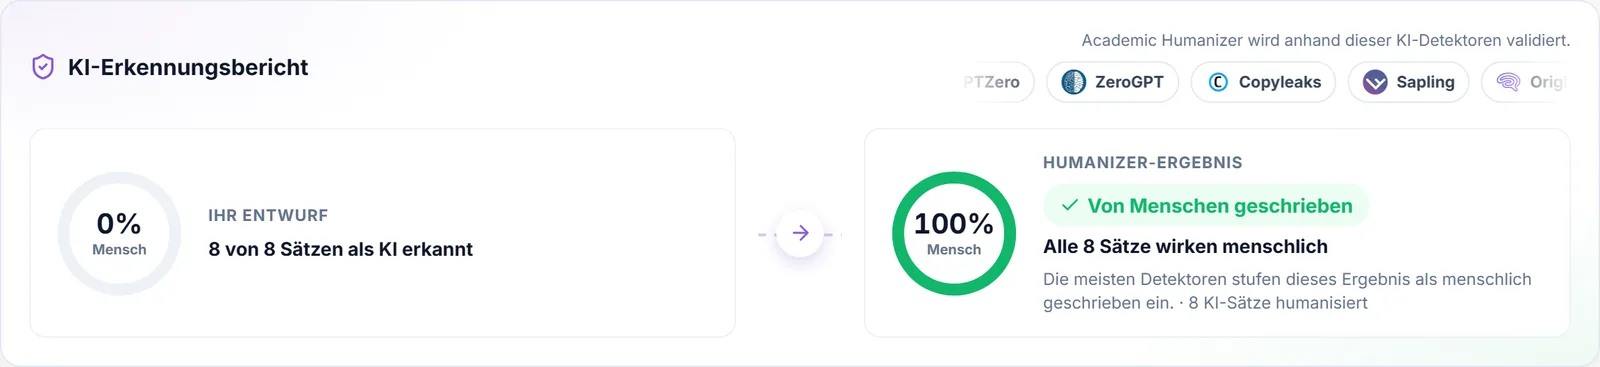
Erkennen KI-Detektoren einen KI-entworfenen Literaturüberblick? In unserem Test taten sie es ausnahmslos: Alle fünf Detektormodelle stimmten beim Entwurf für KI, und alle acht Sätze wurden markiert. Der Absatz stammte aus der Bildungsforschung, und wir haben ihn durch Humanizer v2 geschickt. Nach dem Durchlauf stimmten vier von fünf Modellen für menschlich, jeder Satz las sich als menschlich, und alle vier Zitatgruppen kamen unversehrt heraus.
Die Zitate haben überlebt. Einige der daran geknüpften Aussagen haben das nicht unverändert getan, und genau dieser Teil verdient einen genauen Blick.
Warum Literaturüberblicke markiert werden
Ein Absatz im Literaturüberblick hat eine vorhersehbare Form: Das Feld wächst, Studien zeigen Vorteile, die Effekte schwanken, ein neuerer Strang ist wichtig, eine Lücke bleibt, Forschung ist nötig. Sprachmodelle reproduzieren diese Form flüssig und schmücken sie jedes Mal mit denselben Konnektoren. Unser Entwurf begann Sätze mit „In recent years“, „However“, „For instance“, „Moreover“, „Despite these advances“ und „Consequently“ und verwendete „garnered considerable attention“ und „a pressing need“.
In recent years, the integration of formative assessment practices into higher education has garnered considerable attention from researchers and practitioners alike. Numerous studies have highlighted the potential of formative feedback to enhance student learning outcomes, foster self-regulated learning, and promote deeper engagement with course content (Black & Wiliam, 1998; Nicol & Macfarlane-Dick, 2006). However, the effectiveness of such practices is not uniform across contexts. For instance, Hattie and Timperley (2007) emphasized that the impact of feedback depends heavily on its focus, timing, and the extent to which it addresses the gap between current and desired performance. Moreover, recent scholarship has increasingly recognized the role of student feedback literacy in determining whether feedback is actually used (Carless & Boud, 2018). Despite these advances, a notable gap remains in understanding how large-enrollment courses can implement formative assessment at scale without overburdening instructors. This gap is particularly salient in the context of introductory STEM courses, where class sizes frequently exceed several hundred students. Consequently, there is a pressing need for research that examines scalable, technology-supported approaches to formative feedback in such settings.
Echter Scan aus unserem Testdurchlauf. Alle acht Sätze als KI markiert.Selbst der kurze, schlichte Satz „However, the effectiveness of such practices is not uniform across contexts“ (Die Wirksamkeit solcher Praktiken ist jedoch nicht in allen Kontexten gleich) wurde markiert. Detektoren lesen den Rhythmus eines Absatzes ebenso wie sein Vokabular, und eine Folge gleichmäßig gebauter Sätze zieht jeden einzelnen davon auf die KI-Seite.
Der Durchlauf
- Suche nach KI-SignalenAcht von acht Sätzen markiert; alle fünf Modelle stimmten für KI.
- Umschreiben markierter SätzeAlle acht Sätze wurden umgeschrieben, die Zitate wurden in jeden neuen Satz übernommen.
- Erneute Prüfung mit KI-DetektorenAcht von acht Sätzen lesen sich nun als menschlich; vier von fünf Modellen stimmen für menschlich.
- Speichern des Ergebnisses1.320 Zeichen bei 500 Zeichen pro Credit, aufgerundet: 3 Credits.
- KI-entworfener Absatz5 von 5
- Ausgabe von Humanizer v21 von 5
Haben die Zitate überlebt?
Alle, Zeichen für Zeichen. Das ist in einem Literaturüberblick wichtiger als irgendwo sonst, denn ein verdrehtes Jahr oder ein fehlender Mitautor ist genau die Art Fehler, die bei fachkundigen Gutachtern Glaubwürdigkeit kostet.
| Zitat | In der Ausgabe? | Was sich im Umfeld geändert hat |
|---|---|---|
| Black & Wiliam, 1998 | Ja, unverändert | „Potential“ wurde zu „efficacy“ in der gestützten Aussage |
| Nicol & Macfarlane-Dick, 2006 | Ja, unverändert | Derselbe Satz wie oben |
| Hattie and Timperley (2007) | Ja, unverändert | „Emphasized“ wurde zu „found“; „addresses the gap“ wurde zu „highlights the gap“ |
| Carless & Boud, 2018 | Ja, unverändert | Der Begriff „feedback literacy“ ist weggefallen |
Die Literaturangaben sind also sicher. Genau hinsehen müssen Sie bei der Zuschreibung: Ein Zitat ist ein Versprechen, dass das zitierte Werk sagt, was Ihr Satz ihm zuschreibt. Markiert ein Detektor das Literaturverzeichnis selbst, ist das ein anderes Problem, das wir in Warum Turnitin Quellen und Zitate als KI markiert behandeln.
Wie sich die Abschwächungen verändert haben
Hedging, also das bewusste Abschwächen von Aussagen, ist im Literaturüberblick keine Verzierung. „Highlighted the potential“ (das Potenzial hervorgehoben) und „shown the efficacy“ (die Wirksamkeit gezeigt) treffen unterschiedliche Aussagen über die Evidenz, und Leser aus Ihrem Fach merken, welche Sie gewählt haben.
Vorher
Numerous studies have highlighted the potential of formative feedback to enhance student learning outcomes, foster self-regulated learning, and promote deeper engagement with course content (Black & Wiliam, 1998; Nicol & Macfarlane-Dick, 2006). For instance, Hattie and Timperley (2007) emphasized that the impact of feedback depends heavily on its focus, timing, and the extent to which it addresses the gap between current and desired performance. Moreover, recent scholarship has increasingly recognized the role of student feedback literacy in determining whether feedback is actually used (Carless & Boud, 2018).
Nachher
Many studies have shown the efficacy of formative feedback in improving student learning, facilitating self-regulated learning and enhancing students’ engagement with the course material (Black & Wiliam, 1998; Nicol & Macfarlane-Dick, 2006). Hattie and Timperley (2007), for example, found that the effectiveness of feedback varies based on its focus, timing, and whether it highlights the gap between current and desired performance. More recently, there has been a growing literature that links feedback effectiveness to the ability of students to interpret feedback (Carless & Boud, 2018).
Aus Sicht eines Gutachters lassen sich die Änderungen in drei Gruppen einteilen.
- Stärkere Aussagen. Aus „highlighted the potential“ wurde „shown the efficacy“. Die Formulierung im Entwurf war vorsichtiger, und Vorsicht ist bei der Zusammenfassung eines Forschungsstands meist die sicherere Position.
- Andere Zuschreibungsverben. Der Beitrag von Hattie und Timperley ist ein Review, das ein Feedbackmodell entwickelt. „Emphasized“ (betont) passt dazu; „found“ (festgestellt) legt ein empirisches Ergebnis nahe. Und Feedback, das die Lücke „addresses“ (bearbeitet), ist nicht dasselbe wie Feedback, das sie „highlights“ (sichtbar macht): Das eine schließt die Lücke, das andere zeigt nur auf sie.
- Ein verlorener Fachbegriff. „Student feedback literacy“ ist das Konzept, für das Carless und Boud bekannt sind. Die Neufassung umschreibt es als „ability to interpret feedback“ der Studierenden, und aus „whether feedback is actually used“ (ob Feedback tatsächlich genutzt wird) wurde Interpretation. Wer diesen Beitrag zitiert, will den Begriff zurück.
Was sich in der Forschungslücke geändert hat
Die letzten drei Sätze tragen das Argument des Absatzes: Das fehlt, hier ist es wichtig, das wird gebraucht. Zwei Details haben sich verschoben.
- „Class sizes frequently exceed several hundred students“ wurde zu „many classes have over a hundred students“. Das ist eine sachliche Abschwächung. Wenn Ihre Begründung auf sehr großen Lehrveranstaltungen beruht, stellen Sie die ursprüngliche Angabe wieder her.
- „How large-enrollment courses can implement formative assessment at scale without overburdening instructors“ wurde zu einem Mangel an Forschung zur Umsetzung „in large enrolling courses“. Der Aspekt der Arbeitsbelastung von Lehrenden, also die eigentliche Lücke, ist verschwunden, und „large enrolling courses“ klingt holprig.
Es gibt auch eine gewisse Ironie. Die Neufassung führte „one crucial limitation“ und „significant differences“ ein, zwei Wörter, die sorgfältige Lektoren streichen. Vor allem „significant“ kann in einem bildungswissenschaftlichen Beitrag als statistische Aussage missverstanden werden. Die Detektoren lasen die Sätze trotzdem als menschlich, was zeigt, dass Scan und Hausstil getrennte Urteile sind.
Eine Prüfroutine für humanisierte Literaturüberblicke
- Prüfen Sie jedes Zitat mit Ihrem Literaturverwaltungsprogramm ab: Autoren, Jahr, Zeichensetzung.
- Fragen Sie bei jedem zitierenden Satz, ob das zitierte Werk die neue Fassung tatsächlich stützt. Achten Sie vor allem auf die Verben: found, showed, argued, emphasized, suggested.
- Stellen Sie Fachbegriffe wieder her, die wegparaphrasiert wurden. Benannte Konzepte verbinden Ihren Überblick mit der Literatur.
- Vergleichen Sie Mengenangaben und Wörter, die den Geltungsbereich festlegen („several hundred“, „at scale“, „without overburdening instructors“).
- Prüfen Sie vor der Einreichung die KI-Richtlinie Ihrer Hochschule oder Zeitschrift.
Unsere Leitfäden zu Zitiergewohnheiten bei KI-gestützter Forschung und zum Erhalt der Fachterminologie vertiefen jeden dieser Schritte.
Was das für Sie bedeutet
Bei der Erkennung hat dieser Durchlauf getan, was sich jemand mit einem Literaturüberblick wünscht: Aus acht markierten Sätzen wurden acht menschlich gelesene, und die Zitate kamen unberührt heraus. Bei der Bedeutung entstand ein Entwurf, der eine gezielte Überarbeitung von vielleicht fünf Formulierungen braucht. Das ist ein vernünftiger Tausch, solange die Überarbeitung auch stattfindet.
Academic Humanizer ist um genau diese Überarbeitung herum gebaut. Der KI-Erkennungsbericht stellt jeden Originalsatz seiner Neufassung gegenüber, sodass Sie Zuschreibung und Abschwächung Paar für Paar prüfen können, statt zwei Absätze mit bloßem Auge zu vergleichen.
Ihre Ideen, ohne KI-Fußabdruck
Fügen Sie einen Entwurf ein, sehen Sie, welche Sätze KI-Detektoren markieren, und überarbeiten Sie nur diese mit Humanizer.
Humanizer kostenlos testenWeiterlesen
 Fallstudie
Forschungsantrag mit KI schreiben: echter Test und nötige Prüfung
Aus fünf KI-Stimmen wurden bei einer KI-entworfenen Antragszusammenfassung null. Die Umformulierung strich aber auch drei Jahre Laufzeit und fügte „innovative“ hinzu. Die Prüfung zählt.
Artikel lesen
 Fallstudie
KI-Erkennung im Methodenteil: Warum der Humanizer nichts änderte
Ein KI-entworfener Methodenteil spaltete die Detektoren drei zu zwei, jeder Satz blieb unentschieden, und Humanizer v2 änderte nichts. Hier lesen Sie, warum.
Artikel lesen
 Fallstudie
Markieren KI-Detektoren Nicht-Muttersprachler? Ein echter Test
Die selbst geschriebene Diskussion eines Forschers mit Englisch als Fremdsprache, formelhaft, aber menschlich. Vier von fünf Detektormodellen lasen sie als menschlich, Humanizer v2 ließ sie stehen.
Artikel lesen