

KI-Erkennung im Methodenteil: Warum der Humanizer nichts änderte
Ein KI-entworfener Methodenteil spaltete die Detektoren drei zu zwei, jeder Satz blieb unentschieden, und Humanizer v2 änderte nichts. Hier lesen Sie, warum.
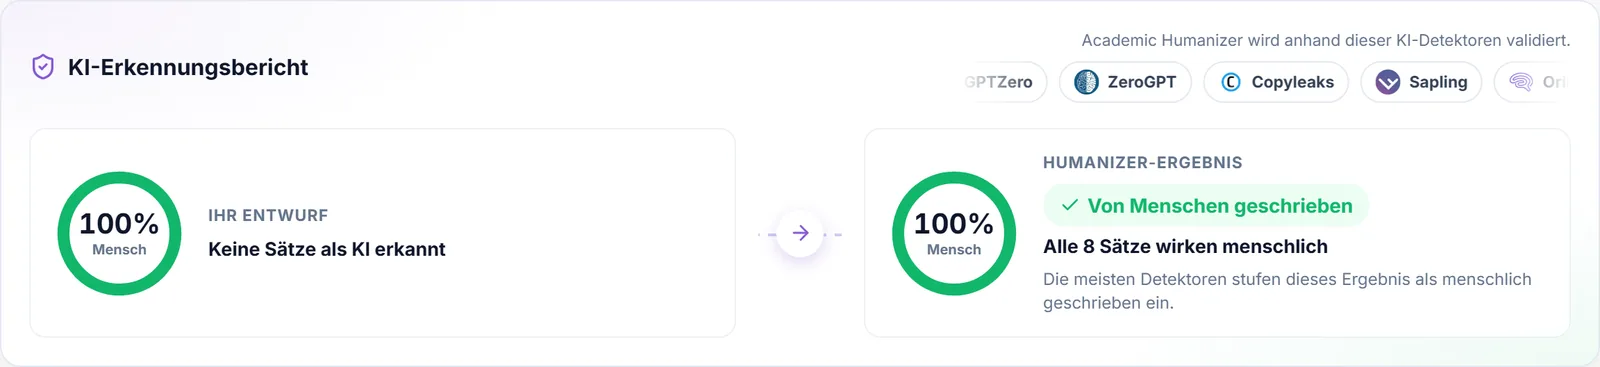
Methodenteile verhalten sich bei der KI-Erkennung anders. Wir haben einen KI-entworfenen Methodenteil aus der Psychologie durch Humanizer v2 geschickt und eine Liste markierter Sätze erwartet. Stattdessen war jeder Satz unklar, das Urteil im Bericht lautete menschlich geschrieben, und Humanizer v2 änderte nichts und berechnete nichts.
Die Detektoren waren sich allerdings nicht einig: Drei von fünf Modellen stimmten für KI, zwei für menschlich. Dieser Beitrag erklärt, was diese Spaltung bedeutet, warum Methodenprosa sie hervorruft und was Autorinnen und Autoren aus einem Durchlauf mitnehmen sollten, der den Text unverändert lässt.
Der Text
Der Entwurf beschreibt ein 2 x 2-Experiment mit Between-Subjects-Design zu Message Framing und Quellenglaubwürdigkeit. Er steckt voller Angaben, die Berichtsstandards verlangen: Einschlusskriterien, Stichprobengröße und Ausschlüsse, Demografie, Design, Randomisierung, Materialien, Messinstrumente mit Reliabilitäten, Vergütung und Ethikvotum. So las der Satzscan den Text.
Participants were recruited through an online research platform and were required to be fluent in English and between 18 and 65 years of age. A total of 412 individuals completed the study, of whom 23 were excluded for failing two or more attention checks, resulting in a final sample of 389 participants (M age = 34.7, SD = 11.2; 52% female). The study employed a 2 x 2 between-subjects design, with message framing (gain vs. loss) and source credibility (high vs. low) as independent variables. Participants were randomly assigned to one of the four conditions using the platform's built-in randomization feature. After providing informed consent, participants read a short article about the benefits of regular physical activity, which was manipulated according to the assigned condition. Subsequently, they completed a series of validated measures, including the 7-item Intentions to Exercise Scale (alpha = .89) and a 5-item perceived credibility scale (alpha = .91). Finally, participants were debriefed and compensated with $2.50 for their time. The study protocol was approved by the university's Institutional Review Board, and all procedures were conducted in accordance with the Declaration of Helsinki.
Echter Scan aus unserem Testdurchlauf. Alle acht Sätze unklar: Jeder neigte leicht zu KI, aber keiner wurde markiert.Acht Sätze, acht bernsteinfarbene Markierungen. Kein einziger wurde sicher als KI gelesen, und kein einziger sicher als menschlich.
Was Humanizer v2 getan hat
- Suche nach KI-SignalenAlle acht Sätze unklar; keiner markiert.
- Umschreiben markierter SätzeKeine markierten Sätze, also null geänderte Sätze.
- Erneute Prüfung mit KI-DetektorenGleicher Text, gleiches Ergebnis: menschlich geschrieben, drei von fünf Modellen stimmen für KI.
- Speichern des ErgebnissesNull Änderungen kosten 0 Credits; 1.214 Zeichen wären sonst 3.
Humanizer v2 schreibt Sätze um, die Detektoren markieren. Unklar ist nicht markiert, also kam nichts in Frage. Die Ausgabe stimmt Zeichen für Zeichen mit der Eingabe überein.
- KI-entworfener Methodenteil3 von 5
- Ausgabe von Humanizer v2 (unverändert)3 von 5
Warum sich Methodenprosa so verhält
Detektoren suchen nach Text, der vorhersehbarer ist, als Menschen üblicherweise schreiben. Methodenteile durchbrechen diese Annahme, denn sie sollen vorhersehbar sein. Einige Gründe, warum dieser Text in der Mitte landet:
- Auch Menschen schreiben Methoden nach Vorlagen. „Participants were randomly assigned to one of the four conditions“ und „approved by the university's Institutional Review Board“ sind Sätze, die Tausende menschlicher Forschender fast wortgleich geschrieben haben. Berichtsstandards drängen alle zur selben Struktur. Wenn menschlicher und maschineller Text bei denselben Formulierungen landen, hat ein Detektor wenig, um sie zu unterscheiden.
- Zahlen und Notation unterbrechen die Prosa. „M age = 34.7, SD = 11.2; 52% female“ und „alpha = .89“ sind nicht die flüssige, zusammenhängende Sprache, auf die Detektoren abgestimmt sind. Sie verdünnen jedes stilistische Signal der umgebenden Wörter.
- Es gibt kaum rhetorische Aufblähung. Der Entwurf hat ein paar maschinelle Gewohnheiten („employed“, „Subsequently“, „a series of validated measures“), stellt aber keine Behauptungen über Bedeutung auf und enthält kein „comprehensive“ oder „underscore“. Genau solche Wendungen haben jeden Satz in unserer Fallstudie zum Abstract in die markierte Spalte gekippt.
Die gespaltene Abstimmung passt zu diesem Bild. Drei von fünf Modellen neigten beim Gesamttext zu KI, zwei nicht, und kein einzelner Satz gab der Prüfung auf Satzebene genug für ein Urteil. Mehr dazu, warum Modelle gerade bei solchen Texten uneins sind, lesen Sie in Warum KI-Detektoren sich widersprechen und KI-Erkennung auf Satzebene.
Jede Zahl blieb genau an ihrem Platz
Für einen Methodenteil ist ein Durchlauf ohne Änderungen das sicherste Ergebnis überhaupt. Nichts wurde umgeschrieben, also konnte sich nichts verschieben:
| Angabe | Wert im Entwurf | Wert in der Ausgabe |
|---|---|---|
| Altersspanne | 18 bis 65 | 18 bis 65 |
| Abgeschlossen / ausgeschlossen / finale Stichprobe | 412 / 23 / 389 | 412 / 23 / 389 |
| Alter (M, SD); % weiblich | 34.7, 11.2; 52% | 34.7, 11.2; 52% |
| Design | 2 x 2 between-subjects | 2 x 2 between-subjects |
| Reliabilität der Skalen | 7-item, alpha = .89; 5-item, alpha = .91 | 7-item, alpha = .89; 5-item, alpha = .91 |
| Vergütung | $2.50 | $2.50 |
Vergleichen Sie das mit einem Tool, das alles paraphrasiert. Ein Methodenteil hat vielleicht ein Dutzend Zahlen, die sich nicht bewegen dürfen, und eine vollständige Umformulierung gibt jeder davon die Chance, gerundet, umgestellt oder der falschen Variablen zugeordnet zu werden. Unser Beitrag zum Erhalt von Bedeutung und Zitaten listet auf, was Sie prüfen sollten, wenn ein Methodenabsatz doch umgeschrieben wird.
Was dieses Ergebnis aussagt und was nicht
Dieser Entwurf wurde mit KI geschrieben, und der Bericht nannte ihn menschlich geschrieben. Das sollte man klar sagen, denn es gilt in beide Richtungen.
- Ein Detektorurteil ist kein Beweis für Urheberschaft. Detektoren schätzen, wie sich ein Text liest. Sie übersehen manchen Maschinentext und markieren manchen menschlichen Text, besonders in konventionellen Textsorten wie Methodenteilen. Siehe Lässt sich KI-generierter Text zuverlässig erkennen?
- Offenlegung ist eine eigene Frage. Ob Sie KI-Unterstützung offenlegen müssen, hängt von der Richtlinie Ihrer Zeitschrift oder Hochschule ab, nicht davon, was ein Detektor sagt. Ein Urteil „menschlich geschrieben“ ändert an dieser Pflicht nichts. Prüfen Sie die Richtlinie vor der Einreichung.
- Für die Details sind weiterhin Sie verantwortlich. KI-Entwürfe können plausible, aber falsche Einzelheiten enthalten: einen Reliabilitätskoeffizienten aus der falschen Studie oder eine Ethikerklärung, die nicht zu Ihrem tatsächlichen Votum passt. Prüfen Sie jeden Wert anhand Ihrer Unterlagen, egal was die Detektoren sagen.
Wenn Sie trotzdem überarbeiten möchten, genügen kleine manuelle Änderungen: „used“ statt „employed“, „Then“ statt „Subsequently“. Prüfen Sie danach erneut; der nächste Scan zeigt Ihnen, ob sich etwas bewegt hat.
Was das für Methodenteile bedeutet
Im Methodenteil richtet KI-gestütztes Schreiben den geringsten stilistischen Schaden an, und dort birgt das Umschreiben das größte sachliche Risiko. In diesem Durchlauf erkannte Humanizer v2, dass nichts markiert war, ließ alle acht Sätze in Ruhe und berechnete nichts. Wie sich die übrigen Abschnitte einer Arbeit verhalten, zeigt unser Leitfaden Abschnitt für Abschnitt zu wissenschaftlichen Arbeiten und KI-Erkennung.
Genau so soll sich Academic Humanizer verhalten: erst prüfen, nur markierte Sätze umschreiben und Ihnen das Ergebnis im KI-Erkennungsbericht zeigen, einschließlich der unklaren Sätze, damit Sie entscheiden können, ob überhaupt etwas Ihre Aufmerksamkeit braucht.
Ihre Ideen, ohne KI-Fußabdruck
Fügen Sie einen Entwurf ein, sehen Sie, welche Sätze KI-Detektoren markieren, und überarbeiten Sie nur diese mit Humanizer.
Humanizer kostenlos testenWeiterlesen
 Fallstudie
Forschungsantrag mit KI schreiben: echter Test und nötige Prüfung
Aus fünf KI-Stimmen wurden bei einer KI-entworfenen Antragszusammenfassung null. Die Umformulierung strich aber auch drei Jahre Laufzeit und fügte „innovative“ hinzu. Die Prüfung zählt.
Artikel lesen
 Fallstudie
Markieren KI-Detektoren Nicht-Muttersprachler? Ein echter Test
Die selbst geschriebene Diskussion eines Forschers mit Englisch als Fremdsprache, formelhaft, aber menschlich. Vier von fünf Detektormodellen lasen sie als menschlich, Humanizer v2 ließ sie stehen.
Artikel lesen
 Fallstudie
KI-Erkennung im Literaturüberblick: echter Test mit geprüften Zitaten
Wir haben einen KI-entworfenen Absatz aus einem Literaturüberblick durch Humanizer v2 geschickt. Alle Zitate blieben intakt. Manche der damit verbundenen Aussagen verschoben sich.
Artikel lesen