

方法セクションのAI検出:Humanizerが手を付けなかった理由
AIで下書きした論文の方法セクションでは検出モデルの判定が3対2に割れ、全文が判定保留となり、Humanizer v2は何も変更しませんでした。その理由を解説します。
方法セクションは、AI検出に対してほかの部分とは違う振る舞いをします。AIで下書きした心理学の方法セクションをHumanizer v2にかけ、判定された文がずらりと並ぶことを予想していました。ところが実際には全文が判定保留となり、レポートの判定はHuman-written、Humanizer v2は何も変更せず、料金もかかりませんでした。
ただし、検出モデル同士の判定は一致していませんでした。五つのモデルのうち三つがAI、二つが人間と判定したのです。この記事では、この判定の割れが何を意味するのか、なぜ方法セクションの文章でこうなるのか、そしてテキストに手を付けなかった実行結果から著者が何を読み取るべきかを説明します。
テキスト
この下書きは、メッセージのフレーミングと情報源の信頼性に関する2×2の参加者間実験を記述したものです。報告基準が求める詳細がぎっしり詰まっています。参加基準、サンプルサイズと除外、属性、研究デザイン、無作為割り付け、材料、信頼性係数付きの尺度、謝礼、倫理審査の承認です。文ごとのスキャン結果は次のとおりでした。
Participants were recruited through an online research platform and were required to be fluent in English and between 18 and 65 years of age. A total of 412 individuals completed the study, of whom 23 were excluded for failing two or more attention checks, resulting in a final sample of 389 participants (M age = 34.7, SD = 11.2; 52% female). The study employed a 2 x 2 between-subjects design, with message framing (gain vs. loss) and source credibility (high vs. low) as independent variables. Participants were randomly assigned to one of the four conditions using the platform's built-in randomization feature. After providing informed consent, participants read a short article about the benefits of regular physical activity, which was manipulated according to the assigned condition. Subsequently, they completed a series of validated measures, including the 7-item Intentions to Exercise Scale (alpha = .89) and a 5-item perceived credibility scale (alpha = .91). Finally, participants were debriefed and compensated with $2.50 for their time. The study protocol was approved by the university's Institutional Review Board, and all procedures were conducted in accordance with the Declaration of Helsinki.
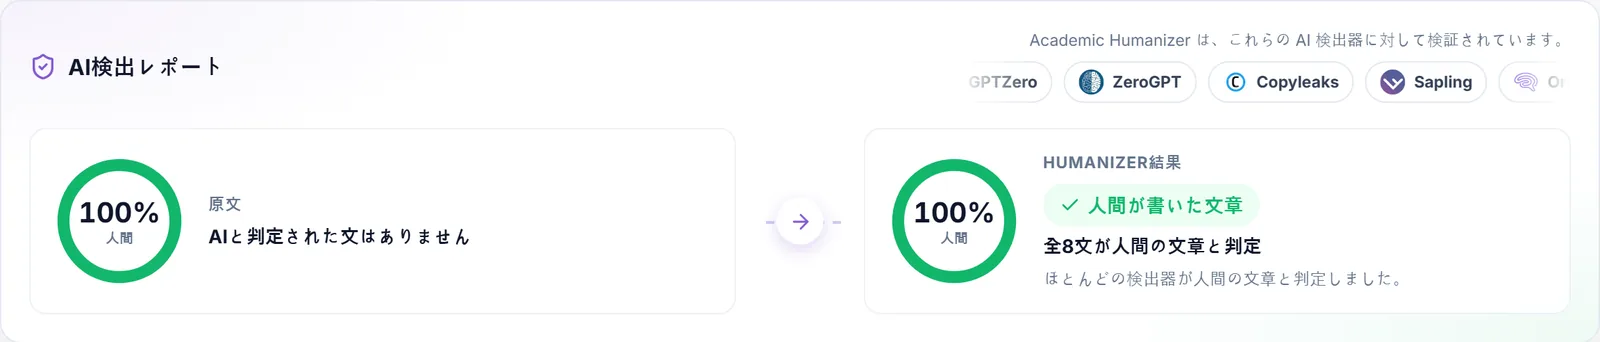
テスト実行時の実際のスキャン結果。8文すべてが判定保留でした。どの文もわずかにAI寄りでしたが、判定された文はありません。8文に8つの琥珀色の印。確信をもってAIと読まれた文も、確信をもって人間と読まれた文も、一つもありませんでした。
Humanizer v2が行ったこと
- AIシグナルのスキャン8文すべてが判定保留で、判定された文はゼロ。
- 判定された文の書き直し判定された文がないため、変更した文はゼロ。
- AI検出ツールで再チェック同じテキストなので結果も同じ。Human-writtenで、五つのうち三つのモデルがAIと判定。
- 結果の保存変更ゼロなので0クレジット。変更があれば1,214文字で3クレジットでした。
Humanizer v2が書き直すのは、検出ツールに判定された文です。判定保留は判定ではないため、対象になる文はありませんでした。出力は入力と一字一句同じです。
- AIで下書きした方法セクション3/5
- Humanizer v2の出力(変更なし)3/5
方法セクションの文章がこうなる理由
検出ツールは、人間が普段書くよりも予測しやすいテキストを探します。方法セクションはこの前提を崩します。そもそも予測しやすく書くべきものだからです。このテキストが中間にとどまった理由はいくつかあります。
- 人間も方法セクションはテンプレートで書く。「Participants were randomly assigned to one of the four conditions」や「approved by the university's Institutional Review Board」は、何千人もの研究者がほぼ一字一句同じように書いてきた文です。報告基準によって、誰もが同じ構成に寄せられます。人間の文章と機械の文章が同じ言い回しに収束すれば、検出ツールが両者を見分ける手がかりはほとんどありません。
- 数値と記号が文章を分断する。「M age = 34.7, SD = 11.2; 52% female」や「alpha = .89」は、検出ツールが調整されている流暢につながった文章ではありません。周囲の語が持つ文体上の信号を薄めてしまいます。
- 修辞的な誇張が少ない。下書きにはいくつか機械らしい癖(「employed」「Subsequently」「a series of validated measures」)がありますが、重要性を主張する文はなく、「comprehensive」や「underscore」もありません。要旨のケーススタディで、すべての文を判定側に押しやったのはまさにこうした語句でした。
判定の割れもこの見立てと合っています。テキスト全体では五つのうち三つのモデルがAI寄り、二つはそうではなく、文単位のチェックで判断を下せるだけの材料を与えた文は一つもありませんでした。まさにこの種のテキストでモデルの判定が食い違う理由については、AI検出ツールの判定が食い違う理由と文単位のAI検出をご覧ください。
すべての数値がそのまま残った
方法セクションにとって、変更ゼロの実行は考えうる限り最も安全な結果です。何も書き直されていないので、何もずれようがありません。
| 項目 | 下書きの値 | 出力の値 |
|---|---|---|
| 年齢範囲 | 18~65歳 | 18~65歳 |
| 完了/除外/最終サンプル | 412 / 23 / 389 | 412 / 23 / 389 |
| 年齢(M、SD)、女性の割合 | 34.7、11.2、52% | 34.7、11.2、52% |
| 研究デザイン | 2×2の参加者間計画 | 2×2の参加者間計画 |
| 尺度の信頼性 | 7項目、alpha = .89/5項目、alpha = .91 | 7項目、alpha = .89/5項目、alpha = .91 |
| 謝礼 | $2.50 | $2.50 |
すべてを言い換えるツールと比べてみてください。方法セクションには動かしてはならない数値が十数個あり、全文を書き直せば、そのそれぞれが丸められたり、順序が入れ替わったり、別の変数に結びつけられたりする危険にさらされます。方法の段落が書き直された場合に確認すべき点は、意味と引用を保つ方法の記事にまとめています。
この結果からわかること、わからないこと
この下書きはAIで書かれたものですが、レポートはHuman-writtenと判定しました。これははっきり述べておく価値があります。どちらの方向にも影響するからです。
- 検出ツールの判定は著者の証明ではない。検出ツールはテキストがどう読めるかを推定しているにすぎません。機械の文章を見逃すこともあれば、人間の文章を判定することもあり、方法セクションのような定型的なジャンルでは特にそうです。AI生成テキストは確実に検出できるのかをご覧ください。
- 開示は別の問題。AIの支援を開示しなければならないかどうかは、検出ツールの判定ではなく、ジャーナルや所属機関のポリシーで決まります。Human-writtenの判定が出ても、その義務は変わりません。提出前にポリシーを確認してください。
- 細部の責任は著者にある。AIの下書きは、もっともらしいのに誤った細部を生み出すことがあります。別の研究の信頼性係数や、実際の承認内容と一致しない倫理に関する記述などです。検出ツールの判定がどうであれ、すべての値を記録と照合してください。
それでも手を入れたい場合は、小さな手作業の修正で十分です。「employed」を「used」に、「Subsequently」を「Then」に変える程度です。修正後は再チェックしてください。次のスキャンで、何か変わったかどうかがわかります。
方法セクションについてのまとめ
方法セクションは、論文の中でAIによる下書きが文体面で最も害を及ぼしにくく、書き直しが事実面で最も大きなリスクを伴う部分です。今回の実行では、Humanizer v2は判定された文がないことを認識し、8文すべてに手を付けず、料金もかかりませんでした。論文のほかのセクションがどうなるかは、論文のAI検出をセクション別に解説したガイドをご覧ください。
これこそがAcademic Humanizerの想定どおりの振る舞いです。まずスキャンし、判定された文だけを書き直し、判定保留の文も含めて結果をAI Detection Reportで示します。そのうえで、手を入れる必要がある箇所があるかどうかをあなたが判断できます。
あなたのアイデアを、AIの痕跡なしで
下書きを貼り付けると、AI検出ツールが指摘する文を表示し、その文だけをHumanizerで書き直します。
Humanizerを無料で試す続けて読む
 事例
AIで書いた助成金申請書はバレる?実地テストと必要な確認
AIで下書きした助成金申請書の概要で、AI判定5票が0票になりました。一方で書き換えにより3年の期間が消え、"innovative" が加わりました。確認の工程が重要です。
記事を読む
 事例
非ネイティブの英語はAI判定される?実際の文章でテスト
非ネイティブの研究者が自分で書いた、定型的でも人間らしい考察の段落。五つの検出モデルのうち四つが人間と判定し、Humanizer v2は手を付けませんでした。
記事を読む
 事例
AIで書いた文献レビューはバレる?引用まで確認した実地テスト
AIで下書きした文献レビューの段落は、検出ツールに例外なく判定されました。Humanizer v2にかけると引用はすべてそのまま残りましたが、引用に結びつく主張の一部は変わっていました。
記事を読む