

연구 방법 섹션 AI 탐지: Humanizer가 손대지 않은 이유
AI로 초안을 쓴 연구 방법 섹션에서 탐지기 판정이 3대 2로 갈렸고, 모든 문장이 판정 불가였으며, Humanizer v2는 아무것도 바꾸지 않았습니다. 그 이유를 설명합니다.
연구 방법 섹션은 AI 탐지에서 다르게 반응합니다. AI로 초안을 쓴 심리학 연구 방법 섹션을 Humanizer v2로 처리하면서 표시된 문장 목록이 나오리라 예상했습니다. 그런데 모든 문장이 판정 불가로 나왔고, 리포트 판정은 사람 작성이었으며, Humanizer v2는 아무것도 바꾸지 않고 비용도 받지 않았습니다.
다만 탐지기끼리 의견이 일치하지는 않았습니다. 다섯 모델 중 셋은 AI, 둘은 사람으로 판정했습니다. 이 글에서는 이런 엇갈림이 무엇을 뜻하는지, 왜 연구 방법 문장에서 이런 결과가 나오는지, 그리고 텍스트를 그대로 둔 실행에서 저자가 무엇을 얻어야 하는지 설명합니다.
텍스트
초안은 메시지 프레이밍과 정보원 신뢰도에 관한 2 x 2 피험자 간 실험을 기술합니다. 보고 기준이 요구하는 세부 정보가 빼곡합니다. 참가 자격, 표본 크기와 제외 기준, 인구통계, 설계, 무작위 배정, 자료, 신뢰도를 포함한 측정 도구, 보상, 윤리 승인까지 들어 있습니다. 문장 검사 결과는 다음과 같습니다.
Participants were recruited through an online research platform and were required to be fluent in English and between 18 and 65 years of age. A total of 412 individuals completed the study, of whom 23 were excluded for failing two or more attention checks, resulting in a final sample of 389 participants (M age = 34.7, SD = 11.2; 52% female). The study employed a 2 x 2 between-subjects design, with message framing (gain vs. loss) and source credibility (high vs. low) as independent variables. Participants were randomly assigned to one of the four conditions using the platform's built-in randomization feature. After providing informed consent, participants read a short article about the benefits of regular physical activity, which was manipulated according to the assigned condition. Subsequently, they completed a series of validated measures, including the 7-item Intentions to Exercise Scale (alpha = .89) and a 5-item perceived credibility scale (alpha = .91). Finally, participants were debriefed and compensated with $2.50 for their time. The study protocol was approved by the university's Institutional Review Board, and all procedures were conducted in accordance with the Declaration of Helsinki.
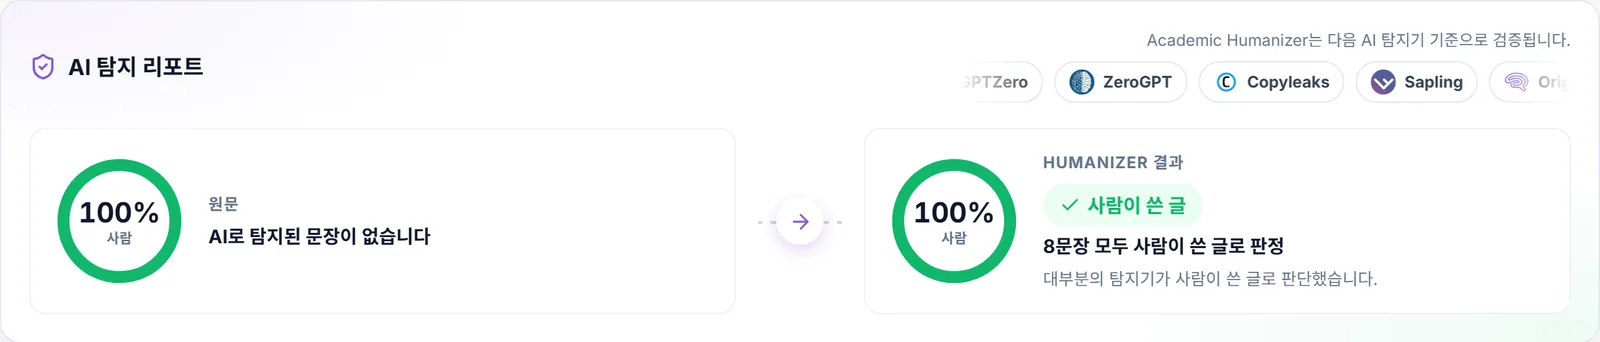
테스트 실행의 실제 검사 결과입니다. 여덟 문장 모두 판정 불가였습니다. 모두 AI 쪽으로 약간 기울었지만 표시된 문장은 없었습니다.여덟 문장, 여덟 개의 호박색 표시입니다. 확실히 AI로 읽힌 문장도, 확실히 사람으로 읽힌 문장도 하나도 없었습니다.
Humanizer v2가 한 일
- AI 신호 검사여덟 문장 모두 판정 불가, 표시된 문장 없음.
- 표시된 문장 고쳐 쓰기표시된 문장이 없어 바뀐 문장도 0개.
- AI 탐지기로 재검사같은 텍스트, 같은 결과: 사람 작성, 다섯 모델 중 셋은 AI로 판정.
- 결과 저장변경 0건이므로 0크레딧. 변경이 있었다면 1,214자는 3크레딧입니다.
Humanizer v2는 탐지기가 표시한 문장을 고쳐 씁니다. 판정 불가는 표시가 아니므로 대상이 된 문장이 없었습니다. 출력은 입력과 한 글자도 다르지 않습니다.
- AI 초안 연구 방법 섹션5개 중 3개
- Humanizer v2 결과(변경 없음)5개 중 3개
연구 방법 문장이 이렇게 반응하는 이유
탐지기는 사람이 보통 쓰는 것보다 더 예측 가능한 텍스트를 찾습니다. 연구 방법 섹션은 이 전제를 깨뜨립니다. 원래 예측 가능하게 써야 하는 글이기 때문입니다. 이 텍스트가 중간에 머문 이유는 몇 가지입니다.
- 사람도 연구 방법은 틀에 맞춰 씁니다. "Participants were randomly assigned to one of the four conditions"나 "approved by the university's Institutional Review Board"는 수천 명의 연구자가 거의 한 글자도 다르지 않게 써 온 문장입니다. 보고 기준은 모두를 같은 구조로 이끕니다. 사람의 글과 기계의 글이 같은 표현으로 수렴하면 탐지기가 둘을 구분할 단서가 거의 없습니다.
- 숫자와 기호가 문장을 끊습니다. "M age = 34.7, SD = 11.2; 52% female"이나 "alpha = .89"는 탐지기가 맞춰져 있는 유창하게 이어지는 언어가 아닙니다. 주변 단어가 지닌 문체 신호를 희석합니다.
- 수사적 과장이 거의 없습니다. 초안에는 "employed", "Subsequently", "a series of validated measures" 같은 기계 특유의 습관이 몇 가지 있지만, 중요성을 주장하지 않고 "comprehensive"나 "underscore"도 쓰지 않습니다. 바로 이런 표현 때문에 초록 사례 연구에서는 모든 문장이 표시되었습니다.
엇갈린 판정도 이 그림과 맞아떨어집니다. 다섯 모델 중 셋은 전체 텍스트를 AI 쪽으로 보았고 둘은 그렇지 않았으며, 문장 단위 검사가 판정을 내릴 만큼 근거를 준 문장은 하나도 없었습니다. 바로 이런 텍스트에서 모델들의 의견이 갈리는 이유는 AI 탐지기 결과가 서로 다른 이유와 문장 단위 AI 탐지에서 더 자세히 다룹니다.
모든 숫자가 정확히 제자리에 남았습니다
연구 방법 섹션에서 변경 없는 실행은 가장 안전한 결과입니다. 고쳐 쓴 것이 없으니 어긋날 것도 없습니다.
| 항목 | 초안의 값 | 결과의 값 |
|---|---|---|
| 연령 범위 | 18 to 65 | 18 to 65 |
| 완료 / 제외 / 최종 표본 | 412 / 23 / 389 | 412 / 23 / 389 |
| 연령(M, SD), 여성 비율 | 34.7, 11.2; 52% | 34.7, 11.2; 52% |
| 설계 | 2 x 2 between-subjects | 2 x 2 between-subjects |
| 척도 신뢰도 | 7-item, alpha = .89; 5-item, alpha = .91 | 7-item, alpha = .89; 5-item, alpha = .91 |
| 보상 | $2.50 | $2.50 |
모든 문장을 패러프레이즈하는 도구와 비교해 보세요. 연구 방법 섹션에는 움직이면 안 되는 숫자가 열 개 남짓 있고, 전체를 고쳐 쓰면 그 하나하나가 반올림되거나, 순서가 바뀌거나, 엉뚱한 변수에 붙을 위험이 생깁니다. 연구 방법 문단이 실제로 고쳐 쓰였을 때 무엇을 확인해야 하는지는 의미와 인용을 지키는 법에 정리되어 있습니다.
이 결과가 말해 주는 것과 말해 주지 않는 것
이 초안은 AI로 썼는데 리포트는 사람 작성이라고 판정했습니다. 이 점은 분명히 짚어 둘 필요가 있습니다. 양쪽으로 다 해석될 수 있기 때문입니다.
- 탐지기 판정은 저작의 증거가 아닙니다. 탐지기는 텍스트가 어떻게 읽히는지를 추정할 뿐입니다. 특히 연구 방법처럼 관례적인 장르에서는 기계가 쓴 글 일부를 놓치고 사람이 쓴 글 일부를 표시합니다. AI 생성 텍스트는 신뢰성 있게 탐지할 수 있을까를 참고하세요.
- 공개 여부는 별개의 문제입니다. AI 도움을 공개해야 하는지는 탐지기 결과가 아니라 학술지나 기관의 정책에 달려 있습니다. 사람 작성 판정이 나왔다고 그 의무가 바뀌지 않습니다. 제출 전에 정책을 확인하세요.
- 세부 사항의 책임은 여전히 저자에게 있습니다. AI 초안은 그럴듯하지만 틀린 세부 정보를 만들어 낼 수 있습니다. 다른 연구의 신뢰도 계수나 실제 승인 내용과 맞지 않는 윤리 문구 같은 것입니다. 탐지기가 뭐라고 하든 모든 값을 기록과 대조하세요.
그래도 고치고 싶다면 작은 수작업 수정이면 충분합니다. "employed"를 "used"로, "Subsequently"를 "Then"으로 바꾸는 정도입니다. 수정 후에는 다시 검사하세요. 다음 검사에서 무언가 달라졌는지 알 수 있습니다.
연구 방법 섹션에서 얻을 교훈
연구 방법은 논문에서 AI 초안이 문체상 피해를 가장 적게 주고, 고쳐 쓰기가 사실관계에 가장 큰 위험을 주는 부분입니다. 이번 실행에서 Humanizer v2는 표시된 문장이 없음을 인식하고 여덟 문장을 모두 그대로 두었으며 비용도 받지 않았습니다. 논문의 다른 섹션이 어떻게 판정되는지는 논문 AI 검사 섹션별 가이드를 참고하세요.
Academic Humanizer는 원래 이렇게 동작하도록 만들어졌습니다. 먼저 검사하고, 표시된 문장만 고쳐 쓰며, 판정 불가 문장까지 포함한 결과를 AI 탐지 리포트로 보여 주어 무엇이 주의가 필요한지, 혹은 아무것도 필요 없는지 직접 판단할 수 있게 합니다.
당신의 아이디어, AI 흔적 없이
초안을 붙여 넣으면 AI 탐지기가 어떤 문장을 표시하는지 보여 주고, 그 문장만 Humanizer로 다듬습니다.
Humanizer 무료로 써 보기이어서 읽기
 사례
연구비 제안서와 AI 글쓰기: 실제 테스트와 필요한 검토
AI로 쓴 연구비 제안서 요약에서 AI 판정 5표가 0표가 되었습니다. 하지만 3년 기간이 빠지고 "innovative"가 추가되었습니다. 검토 단계가 중요합니다.
글 읽기
 사례
AI 탐지기는 비원어민 영어를 AI로 판정할까? 실제 테스트
비원어민 영어 연구자가 직접 쓴, 정형화되었지만 사람이 쓴 고찰 문단입니다. 탐지 모델 다섯 중 넷이 사람 글로 판정했고, Humanizer v2는 그대로 두었습니다.
글 읽기
 사례
문헌 검토 AI 탐지: 인용까지 확인한 실제 테스트
AI로 초안을 쓴 문헌 검토 문단을 Humanizer v2로 처리했습니다. 인용은 모두 그대로 남았지만, 인용에 붙은 주장 일부는 달라졌습니다.
글 읽기