论文方法部分AI检测:为何 Humanizer 一字未改
一段 AI 起草的研究方法部分让检测器三比二分歧,每个句子都是“不确定”,Humanizer v2 一字未改。本文解释原因。
研究方法部分在 AI 检测下的表现与众不同。我们用 Humanizer v2 处理了一段 AI 起草的心理学研究方法部分,本以为会得到一串被标记的句子。结果每个句子都是“不确定”,报告结论为“人工撰写”,Humanizer v2 没有改动任何内容,也没有扣费。
不过检测器之间并不一致:五个模型中三个判为 AI,两个判为人写。本文解释这种分歧意味着什么、为什么研究方法类文字会产生这种结果,以及作者应该如何看待一次原样返回的运行。
文本
草稿描述了一项关于信息框架和信源可信度的 2 x 2 被试间实验。其中写满了报告规范要求的细节:入组标准、样本量与排除、人口学信息、设计、随机分配、材料、测量工具及其信度、被试报酬和伦理审批。下面是逐句扫描的结果。
Participants were recruited through an online research platform and were required to be fluent in English and between 18 and 65 years of age. A total of 412 individuals completed the study, of whom 23 were excluded for failing two or more attention checks, resulting in a final sample of 389 participants (M age = 34.7, SD = 11.2; 52% female). The study employed a 2 x 2 between-subjects design, with message framing (gain vs. loss) and source credibility (high vs. low) as independent variables. Participants were randomly assigned to one of the four conditions using the platform's built-in randomization feature. After providing informed consent, participants read a short article about the benefits of regular physical activity, which was manipulated according to the assigned condition. Subsequently, they completed a series of validated measures, including the 7-item Intentions to Exercise Scale (alpha = .89) and a 5-item perceived credibility scale (alpha = .91). Finally, participants were debriefed and compensated with $2.50 for their time. The study protocol was approved by the university's Institutional Review Board, and all procedures were conducted in accordance with the Declaration of Helsinki.
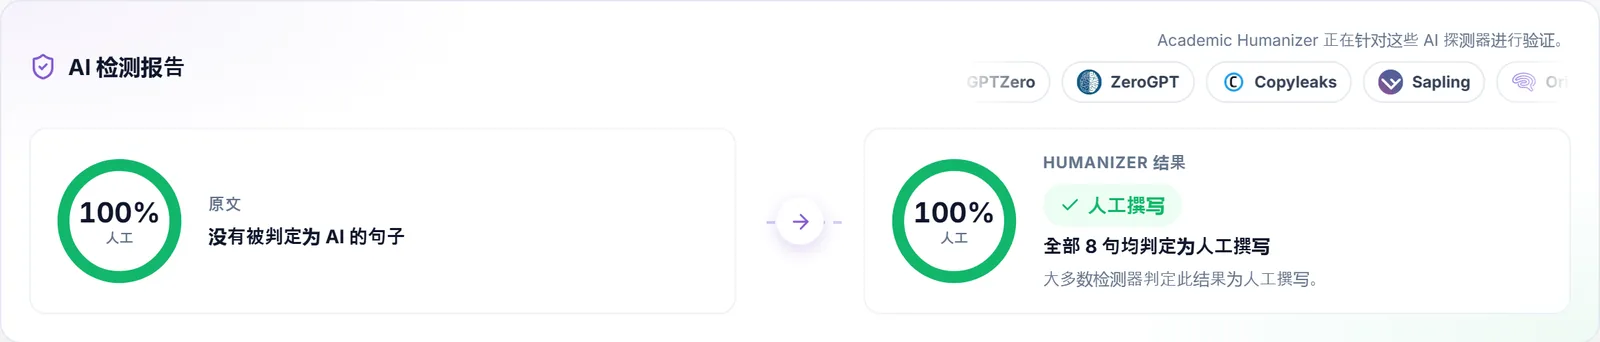
我们测试运行的真实扫描结果。八个句子全部为“不确定”:每句都略微偏向 AI,但没有一句被标记。八个句子,八个琥珀色标记。没有一句被明确判为 AI,也没有一句被明确判为人写。
Humanizer v2 做了什么
- 扫描 AI 信号八个句子全部为“不确定”,没有句子被标记。
- 改写被标记的句子没有被标记的句子,因此改动了零个句子。
- 用 AI 检测器复查文本相同,结果相同:人工撰写,五个模型中三个判为 AI。
- 保存结果零改动,扣费 0 点;否则 1,214 个字符需要 3 点。
Humanizer v2 只改写被检测器标记的句子。“不确定”不算被标记,所以没有句子符合条件。输出与输入逐字符完全一致。
- AI 起草的研究方法部分3 / 5
- Humanizer v2 输出(未改动)3 / 5
为什么研究方法类文字会这样
检测器寻找的是比人通常所写更可预测的文本。研究方法部分打破了这个假设,因为它本来就应该是可预测的。这段文本落在中间地带,有以下几个原因:
- 人写研究方法也套用模板。"Participants were randomly assigned to one of the four conditions"(参与者被随机分配到四种条件之一)和 "approved by the university's Institutional Review Board"(经大学伦理审查委员会批准)这类句子,成千上万的研究者都写过几乎一模一样的版本。报告规范把所有人推向同一种结构。当人写的和机器写的文本收敛到同样的措辞时,检测器就很难区分。
- 数字和符号打断了文字。"M age = 34.7, SD = 11.2; 52% female" 和 "alpha = .89" 并不是检测器所针对的那种流畅连贯的语言。它们冲淡了周围文字所携带的文体信号。
- 几乎没有修辞上的夸张。草稿有一些机器习惯("employed"、"Subsequently"、"a series of validated measures"),但没有关于重要性的论断,也没有 "comprehensive" 或 "underscore"。正是这类措辞让我们的摘要案例研究中每个句子都被标记。
三比二的分歧正符合这个情况。五个模型中有三个就整篇文本而言偏向 AI,两个没有,而句子级检查在任何单个句子上都没有足够依据下结论。关于为什么模型恰恰在这类文本上意见不一,请参阅为什么 AI 检测器结果不一致和句子级 AI 检测。
每个数字都原封不动
对于研究方法部分来说,零改动的运行是最安全的结果。没有任何内容被改写,也就没有任何内容会偏移:
| 细节 | 草稿中的值 | 输出中的值 |
|---|---|---|
| 年龄范围 | 18 至 65 岁 | 18 至 65 岁 |
| 完成 / 排除 / 最终样本 | 412 / 23 / 389 | 412 / 23 / 389 |
| 年龄(M,SD);女性占比 | 34.7, 11.2; 52% | 34.7, 11.2; 52% |
| 设计 | 2 x 2 被试间 | 2 x 2 被试间 |
| 量表信度 | 7 题,alpha = .89;5 题,alpha = .91 | 7 题,alpha = .89;5 题,alpha = .91 |
| 报酬 | $2.50 | $2.50 |
对比一下全文改写的工具。一个研究方法部分可能有十几个不能变动的数字,全文改写会让每一个数字都有被四舍五入、调换顺序或挂到错误变量上的机会。我们关于保留原意和引文的文章列出了研究方法段落被改写后需要检查的内容。
这个结果说明了什么,没说明什么
这份草稿是用 AI 写的,而报告判定为“人工撰写”。这一点值得明说,因为它是一把双刃剑。
- 检测器的结论不能证明作者身份。检测器估计的是文本读起来像什么。它们会漏掉一些机器文本,也会标记一些人写的文本,在研究方法这类程式化体裁中尤其如此。参阅AI 生成的文本能被可靠检测吗。
- 披露是另一个问题。是否必须披露 AI 辅助,取决于期刊或机构的政策,而不是检测器的结果。“人工撰写”的结论不会改变这项义务。投稿前请查看相关政策。
- 细节仍由作者负责。AI 起草可能写出看似合理却错误的细节:来自其他研究的信度系数、与实际审批不符的伦理声明。无论检测器怎么说,都要对照你的记录核实每一个数值。
如果你还是想修改,做一些小的手动改动就够了:用 "used" 代替 "employed",用 "Then" 代替 "Subsequently"。改完后再检测一次,下一次扫描会告诉你结果有没有变化。
关于研究方法部分的结论
在论文中,研究方法部分是 AI 起草造成的文体损害最小、而改写带来的事实风险最大的部分。在这次运行中,Humanizer v2 识别出没有句子被标记,八个句子都没有动,也没有扣费。论文其他章节的表现,请看我们按章节处理研究论文 AI 检测的指南。
这正是 Academic Humanizer 应有的表现:先扫描,只改写被标记的句子,并在 AI Detection Report 中展示结果(包括“不确定”的句子),让你自己决定哪些地方需要关注。
保留你的想法,去除 AI 痕迹
粘贴草稿,查看哪些句子被 AI 检测器标记,然后只用 Humanizer 改写这些句子。
免费试用 Humanizer