

Methods Section AI Detection: Humanizer ने इसे क्यों नहीं छुआ
AI से ड्राफ़्ट किए मेथड्स सेक्शन पर डिटेक्टर तीन बनाम दो में बँटे, हर वाक्य अनिर्णायक रहा, और Humanizer v2 ने कुछ नहीं बदला। वजह यहाँ है।
AI डिटेक्शन में मेथड्स सेक्शन अलग ढंग से व्यवहार करते हैं। हमने AI से ड्राफ़्ट किया गया मनोविज्ञान का एक मेथड्स सेक्शन Humanizer v2 से चलाया, इस उम्मीद में कि फ़्लैग वाक्यों की सूची मिलेगी। इसके बजाय हर वाक्य अनिर्णायक निकला, रिपोर्ट का निष्कर्ष Human-written रहा, और Humanizer v2 ने न कुछ बदला, न कोई शुल्क लिया।
फिर भी डिटेक्टर आपस में सहमत नहीं थे: पाँच में से तीन मॉडलों ने AI और दो ने इंसानी लेखन के पक्ष में वोट दिया। यह पोस्ट बताती है कि इस बँटवारे का मतलब क्या है, मेथड्स का गद्य ऐसा नतीजा क्यों देता है, और जिस रन ने टेक्स्ट को छुआ ही नहीं, उससे लेखक को क्या समझना चाहिए।
टेक्स्ट
ड्राफ़्ट मैसेज फ़्रेमिंग और स्रोत की विश्वसनीयता पर 2 x 2 बिटवीन-सब्जेक्ट्स प्रयोग का वर्णन करता है। इसमें वे सभी ब्योरे भरे हैं जो रिपोर्टिंग मानक माँगते हैं: पात्रता मानदंड, सैंपल साइज़ और बहिष्करण, जनसांख्यिकी, डिज़ाइन, रैंडमाइज़ेशन, सामग्री, विश्वसनीयता सहित माप, पारिश्रमिक और एथिक्स अनुमोदन। वाक्य स्कैन ने इसे ऐसे पढ़ा।
Participants were recruited through an online research platform and were required to be fluent in English and between 18 and 65 years of age. A total of 412 individuals completed the study, of whom 23 were excluded for failing two or more attention checks, resulting in a final sample of 389 participants (M age = 34.7, SD = 11.2; 52% female). The study employed a 2 x 2 between-subjects design, with message framing (gain vs. loss) and source credibility (high vs. low) as independent variables. Participants were randomly assigned to one of the four conditions using the platform's built-in randomization feature. After providing informed consent, participants read a short article about the benefits of regular physical activity, which was manipulated according to the assigned condition. Subsequently, they completed a series of validated measures, including the 7-item Intentions to Exercise Scale (alpha = .89) and a 5-item perceived credibility scale (alpha = .91). Finally, participants were debriefed and compensated with $2.50 for their time. The study protocol was approved by the university's Institutional Review Board, and all procedures were conducted in accordance with the Declaration of Helsinki.
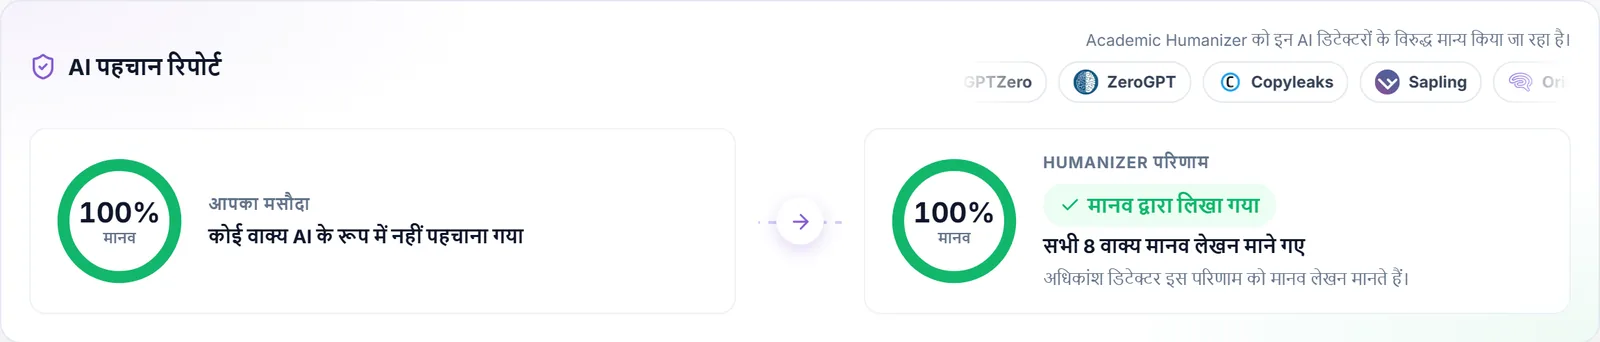
हमारे टेस्ट रन का असली स्कैन। आठों वाक्य अनिर्णायक: हर वाक्य AI की ओर थोड़ा झुका, लेकिन कोई फ़्लैग नहीं हुआ।आठ वाक्य, आठ एम्बर निशान। एक भी वाक्य को पूरे भरोसे से AI नहीं पढ़ा गया, और एक भी को पूरे भरोसे से इंसानी नहीं।
Humanizer v2 ने क्या किया
- AI संकेतों के लिए स्कैनिंगआठों वाक्य अनिर्णायक; कोई फ़्लैग नहीं।
- फ़्लैग हुए वाक्यों को दोबारा लिखनाकोई फ़्लैग वाक्य नहीं, इसलिए शून्य वाक्य बदले।
- AI डिटेक्टरों से दोबारा जाँचवही टेक्स्ट, वही नतीजा: Human-written, पाँच में से तीन मॉडलों का वोट AI।
- आपका परिणाम सहेजनाशून्य बदलाव पर 0 क्रेडिट; वरना 1,214 कैरेक्टर के 3 लगते।
Humanizer v2 उन वाक्यों को दोबारा लिखता है जिन्हें डिटेक्टर फ़्लैग करते हैं। अनिर्णायक का मतलब फ़्लैग नहीं है, इसलिए कोई वाक्य योग्य नहीं था। आउटपुट इनपुट से अक्षरशः मेल खाता है।
- AI से ड्राफ़्ट किया गया मेथड्स सेक्शन5 में से 3
- Humanizer v2 आउटपुट (बिना बदलाव)5 में से 3
मेथड्स का गद्य ऐसा व्यवहार क्यों करता है
डिटेक्टर ऐसा टेक्स्ट खोजते हैं जो लोगों के आम लेखन से ज़्यादा अनुमान-योग्य हो। मेथड्स सेक्शन इस धारणा को तोड़ते हैं, क्योंकि उनका अनुमान-योग्य होना ही अपेक्षित है। यह टेक्स्ट बीच में क्यों टिका, इसके कुछ कारण:
- इंसान भी मेथड्स साँचों से लिखते हैं। "Participants were randomly assigned to one of the four conditions" और "approved by the university's Institutional Review Board" ऐसे वाक्य हैं जिन्हें हज़ारों इंसानी शोधकर्ताओं ने लगभग शब्दशः लिखा है। रिपोर्टिंग मानक सबको एक ही ढाँचे की ओर धकेलते हैं। जब इंसानी और मशीनी टेक्स्ट एक जैसी भाषा पर आ मिलते हैं, तो डिटेक्टर के पास उन्हें अलग करने को बहुत कम बचता है।
- संख्याएँ और संकेतन गद्य को तोड़ते हैं। "M age = 34.7, SD = 11.2; 52% female" और "alpha = .89" वह धाराप्रवाह, जुड़ी हुई भाषा नहीं है जिस पर डिटेक्टर ट्यून किए जाते हैं। ये आसपास के शब्दों के शैलीगत संकेत को फीका कर देते हैं।
- अलंकारिक फुलाव बहुत कम है। ड्राफ़्ट में कुछ मशीनी आदतें हैं ("employed", "Subsequently", "a series of validated measures"), लेकिन यह महत्व के बारे में कोई दावा नहीं करता और इसमें "comprehensive" या "underscore" नहीं है। यही वे वाक्यांश थे जिन्होंने हमारी एब्स्ट्रैक्ट केस स्टडी के हर वाक्य को फ़्लैग वाले कॉलम में धकेल दिया था।
बँटा हुआ वोट इसी तस्वीर में फ़िट बैठता है। पूरे टेक्स्ट पर पाँच में से तीन मॉडल AI की ओर झुके, दो नहीं, और किसी एक वाक्य ने वाक्य-स्तरीय जाँच को फ़ैसला करने लायक संकेत नहीं दिया। ठीक इसी तरह के टेक्स्ट पर मॉडल असहमत क्यों होते हैं, इसके लिए देखें AI डिटेक्टर आपस में असहमत क्यों होते हैं और वाक्य-स्तरीय AI डिटेक्शन।
हर संख्या ठीक अपनी जगह रही
मेथड्स सेक्शन के लिए शून्य-बदलाव वाला रन सबसे सुरक्षित संभव नतीजा है। कुछ दोबारा नहीं लिखा गया, इसलिए कुछ खिसक भी नहीं सकता था:
| ब्योरा | ड्राफ़्ट में मान | आउटपुट में मान |
|---|---|---|
| आयु सीमा | 18 से 65 | 18 से 65 |
| पूरा किया / बाहर किए गए / अंतिम सैंपल | 412 / 23 / 389 | 412 / 23 / 389 |
| आयु (M, SD); % महिलाएँ | 34.7, 11.2; 52% | 34.7, 11.2; 52% |
| डिज़ाइन | 2 x 2 बिटवीन-सब्जेक्ट्स | 2 x 2 बिटवीन-सब्जेक्ट्स |
| स्केल की विश्वसनीयता | 7-आइटम, alpha = .89; 5-आइटम, alpha = .91 | 7-आइटम, alpha = .89; 5-आइटम, alpha = .91 |
| पारिश्रमिक | $2.50 | $2.50 |
इसकी तुलना ऐसे टूल से करें जो सब कुछ पैराफ़्रेज़ करता है। किसी मेथड्स सेक्शन में शायद दर्जन भर संख्याएँ होती हैं जिन्हें हिलना नहीं चाहिए, और पूरा रीराइट उनमें से हर एक को गोल होने, क्रम बदलने या गलत वेरिएबल से जुड़ने का मौक़ा देता है। हमारी पोस्ट अर्थ और उद्धरण सुरक्षित रखना बताती है कि अगर मेथड्स का कोई पैराग्राफ़ दोबारा लिखा जाए तो क्या जाँचें।
यह नतीजा क्या बताता है और क्या नहीं
यह ड्राफ़्ट AI से लिखा गया था, और रिपोर्ट ने इसे Human-written कहा। यह साफ़ कहना ज़रूरी है, क्योंकि यह दोनों तरफ़ लागू होता है।
- डिटेक्टर का निष्कर्ष लेखकत्व का सबूत नहीं है। डिटेक्टर अनुमान लगाते हैं कि टेक्स्ट कैसा पढ़ा जाता है। वे कुछ मशीनी टेक्स्ट चूक जाते हैं और कुछ इंसानी टेक्स्ट फ़्लैग कर देते हैं, ख़ासकर मेथड्स जैसी पारंपरिक विधाओं में। देखें क्या AI-जनित टेक्स्ट को भरोसेमंद ढंग से पकड़ा जा सकता है।
- प्रकटीकरण अलग सवाल है। AI सहायता बतानी है या नहीं, यह आपके जर्नल या संस्थान की नीति पर निर्भर है, डिटेक्टर के कहे पर नहीं। Human-written निष्कर्ष से वह दायित्व नहीं बदलता। जमा करने से पहले नीति देखें।
- ब्योरों की ज़िम्मेदारी फिर भी लेखक की है। AI ड्राफ़्टिंग ऐसे ब्योरे बना सकती है जो विश्वसनीय लगें पर गलत हों: किसी और अध्ययन का विश्वसनीयता गुणांक, या ऐसा एथिक्स कथन जो आपके असली अनुमोदन से मेल न खाए। डिटेक्टर कुछ भी कहें, हर मान को अपने रिकॉर्ड से मिलाएँ।
अगर आप फिर भी संपादन करना चाहें, तो छोटे हाथ से किए बदलाव काफ़ी हैं: "employed" की जगह "used", "Subsequently" की जगह "Then"। बाद में दोबारा जाँचें; अगला स्कैन बता देगा कि कुछ हिला या नहीं।
मेथड्स सेक्शन के लिए सबक
मेथड्स का गद्य पेपर का वह हिस्सा है जहाँ AI ड्राफ़्टिंग शैली को सबसे कम नुक़सान पहुँचाती है और जहाँ रीराइटिंग में तथ्यों का सबसे ज़्यादा जोखिम है। इस रन में Humanizer v2 ने पहचाना कि कुछ फ़्लैग नहीं हुआ, आठों वाक्य छोड़ दिए, और कोई शुल्क नहीं लिया। पेपर के दूसरे सेक्शन कैसा बर्ताव करते हैं, इसके लिए रिसर्च पेपर और AI डिटेक्शन पर हमारी सेक्शन-दर-सेक्शन गाइड देखें।
Academic Humanizer को ठीक ऐसे ही व्यवहार करना है: पहले स्कैन करना, सिर्फ़ फ़्लैग वाक्य दोबारा लिखना, और नतीजा AI Detection Report में दिखाना, अनिर्णायक वाक्यों सहित, ताकि आप तय कर सकें कि किस चीज़ पर, अगर किसी पर, आपका ध्यान चाहिए।
आपके विचार, बिना AI की छाप के
ड्राफ़्ट पेस्ट करें, देखें कि AI डिटेक्टर किन वाक्यों को चिह्नित करते हैं, और केवल उन्हीं वाक्यों को Humanizer से सुधारें।
Humanizer मुफ़्त आज़माएँआगे पढ़ें
 केस स्टडी
Grant Proposal AI Writing: एक असली टेस्ट और ज़रूरी समीक्षा
AI से ड्राफ़्ट किए ग्रांट सारांश पर पाँच AI वोट शून्य हो गए। रीराइट ने तीन साल की अवधि भी हटा दी और "innovative" जोड़ दिया। समीक्षा का चरण ज़रूरी है।
लेख पढ़ें
 केस स्टडी
क्या AI Detector Non-Native English लेखन फ़्लैग करते हैं? असली टेस्ट
एक non-native English शोधकर्ता का अपना डिस्कशन पैराग्राफ़, साँचेदार पर इंसानी। पाँच में से चार डिटेक्टर मॉडलों ने उसे इंसानी पढ़ा, और Humanizer v2 ने उसे नहीं छुआ।
लेख पढ़ें
 केस स्टडी
AI Literature Review Detection: उद्धरणों की जाँच के साथ असली टेस्ट
हमने AI से ड्राफ़्ट किया एक लिटरेचर रिव्यू पैराग्राफ़ Humanizer v2 से चलाया। हर citation सुरक्षित रही। उनसे जुड़े कुछ दावे खिसक गए।
लेख पढ़ें