

AIで書いた文献レビューはバレる?引用まで確認した実地テスト
AIで下書きした文献レビューの段落は、検出ツールに例外なく判定されました。Humanizer v2にかけると引用はすべてそのまま残りましたが、引用に結びつく主張の一部は変わっていました。
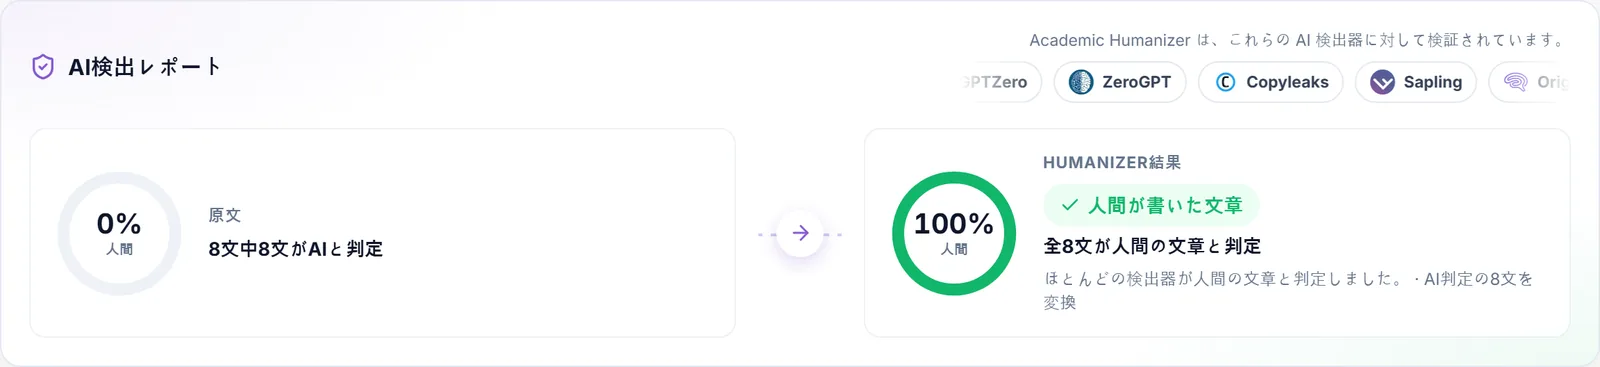
AIで下書きした文献レビューは、AI検出ツールに見抜かれるのでしょうか。私たちのテストでは、例外なく見抜かれました。下書きに対しては五つの検出モデルすべてがAIと判定し、8文すべてが判定されました。段落は教育学研究のもので、Humanizer v2にかけました。実行後は、五つのうち四つのモデルが人間と判定し、すべての文が人間の文として読まれ、四つの引用グループもすべて無傷で残りました。
引用は残りました。ただし、引用に結びついた主張の一部はそのままではありませんでした。じっくり読む価値があるのはこの部分です。
文献レビューの文章が判定されやすい理由
文献レビューの段落には決まった型があります。分野が拡大している、研究が利点を示している、効果にはばらつきがある、最近の新しい流れが重要だ、ギャップが残っている、研究が必要だ。言語モデルはこの型を流暢に再現し、毎回同じ接続語で飾り立てます。今回の下書きでも、文頭に「In recent years」「However」「For instance」「Moreover」「Despite these advances」「Consequently」が並び、「garnered considerable attention」や「a pressing need」も使われていました。
In recent years, the integration of formative assessment practices into higher education has garnered considerable attention from researchers and practitioners alike. Numerous studies have highlighted the potential of formative feedback to enhance student learning outcomes, foster self-regulated learning, and promote deeper engagement with course content (Black & Wiliam, 1998; Nicol & Macfarlane-Dick, 2006). However, the effectiveness of such practices is not uniform across contexts. For instance, Hattie and Timperley (2007) emphasized that the impact of feedback depends heavily on its focus, timing, and the extent to which it addresses the gap between current and desired performance. Moreover, recent scholarship has increasingly recognized the role of student feedback literacy in determining whether feedback is actually used (Carless & Boud, 2018). Despite these advances, a notable gap remains in understanding how large-enrollment courses can implement formative assessment at scale without overburdening instructors. This gap is particularly salient in the context of introductory STEM courses, where class sizes frequently exceed several hundred students. Consequently, there is a pressing need for research that examines scalable, technology-supported approaches to formative feedback in such settings.
テスト実行時の実際のスキャン結果。8文すべてがAIと判定されました。「However, the effectiveness of such practices is not uniform across contexts」という短く平易な文でさえ判定されました。検出ツールは語彙だけでなく段落のリズムも読みます。均一に組み立てられた文が続くと、その一つひとつがAI寄りに引っ張られるのです。
実行結果
- AIシグナルのスキャン8文中8文が判定され、五つのモデルすべてがAIと判定。
- 判定された文の書き直し8文すべてを書き直し、引用はそれぞれの新しい文に引き継がれました。
- AI検出ツールで再チェック8文中8文が人間の文として読まれ、五つのうち四つのモデルが人間と判定。
- 結果の保存1,320文字、500文字につき1クレジットで切り上げ:3クレジット。
- AIで下書きした段落5/5
- Humanizer v2の出力1/5
引用は残ったか
すべて、一字一句そのまま残りました。これは文献レビューでは何より重要です。年の誤りや共著者の脱落は、その分野をよく知る査読者からの信頼を失いかねない種類のミスだからです。
| 引用 | 出力に残ったか | 周辺で変わった点 |
|---|---|---|
| Black & Wiliam, 1998 | はい、変更なし | 裏付ける主張の「potential」が「efficacy」に |
| Nicol & Macfarlane-Dick, 2006 | はい、変更なし | 上と同じ文 |
| Hattie and Timperley (2007) | はい、変更なし | 「emphasized」が「found」に、「addresses the gap」が「highlights the gap」に |
| Carless & Boud, 2018 | はい、変更なし | 「feedback literacy」という用語が消えた |
つまり、参考文献そのものは安全です。確認すべきなのは帰属の部分です。引用とは、引用した文献があなたの文が述べているとおりのことを述べている、という約束だからです。検出ツールが参考文献リストそのものを判定した場合は別の問題で、Turnitinで参考文献や引用がAI判定される理由で取り上げています。
ヘッジ表現はどう変わったか
文献レビューにおけるヘッジ表現は飾りではありません。「highlighted the potential」(可能性を指摘した)と「shown the efficacy」(有効性を示した)では、エビデンスについての主張が異なります。同じ分野の読者なら、どちらを選んだかに気づきます。
修正前
Numerous studies have highlighted the potential of formative feedback to enhance student learning outcomes, foster self-regulated learning, and promote deeper engagement with course content (Black & Wiliam, 1998; Nicol & Macfarlane-Dick, 2006). For instance, Hattie and Timperley (2007) emphasized that the impact of feedback depends heavily on its focus, timing, and the extent to which it addresses the gap between current and desired performance. Moreover, recent scholarship has increasingly recognized the role of student feedback literacy in determining whether feedback is actually used (Carless & Boud, 2018).
修正後
Many studies have shown the efficacy of formative feedback in improving student learning, facilitating self-regulated learning and enhancing students’ engagement with the course material (Black & Wiliam, 1998; Nicol & Macfarlane-Dick, 2006). Hattie and Timperley (2007), for example, found that the effectiveness of feedback varies based on its focus, timing, and whether it highlights the gap between current and desired performance. More recently, there has been a growing literature that links feedback effectiveness to the ability of students to interpret feedback (Carless & Boud, 2018).
査読者の目で読むと、変化は三つに分けられます。
- 主張が強くなった。「highlighted the potential」が「shown the efficacy」になりました。下書きの言い回しのほうが慎重で、一連の研究をまとめるときは、慎重な立場のほうが通常は安全です。
- 帰属を表す動詞が変わった。Hattie and Timperleyの論文は、フィードバックのモデルを構築したレビュー論文です。「emphasized」(強調した)はそれに合いますが、「found」(明らかにした)は実証的な結果を示唆します。また、ギャップに「addresses」(対処する)フィードバックと「highlights」(浮き彫りにする)フィードバックは同じではありません。前者はギャップを埋め、後者は指し示すだけです。
- 用語が失われた。「student feedback literacy」は、Carless and Boudの名とともに知られる概念です。書き直しではこれが学生の「ability to interpret feedback」(フィードバックを解釈する能力)と言い換えられ、「whether feedback is actually used」(実際に活用されるか)も解釈の話にすり替わりました。この論文を引用する著者なら、用語を元に戻したいはずです。
ギャップの記述で変わった点
最後の3文は、段落の論旨を担っています。何が欠けているか、それがどこで重要か、何が必要か。ここで二つの細部が変わりました。
- 「class sizes frequently exceed several hundred students」(数百人を超えることも多い)が「many classes have over a hundred students」(100人を超えるクラスが多い)になりました。これは事実関係の弱体化です。研究の動機が非常に大規模なクラスにあるなら、元に戻してください。
- 「how large-enrollment courses can implement formative assessment at scale without overburdening instructors」が、「in large enrolling courses」での実施に関する研究の不足、という内容になりました。実際のギャップである教員の負担という観点が消え、「large enrolling courses」という表現もぎこちなくなっています。
皮肉な点もあります。書き直しでは「one crucial limitation」や「significant differences」が加わりました。どちらも丁寧な編集者なら削る言葉です。特に「significant」は、教育学の論文では統計的な主張と誤読されるおそれがあります。それでも検出ツールはこれらの文を人間の文と判定しました。スキャンの判定と文体上の判断は別物だということがわかります。
ヒューマナイズした文献レビューの確認手順
- すべての引用を文献管理ツールと照合します。著者、年、句読点まで確認します。
- 引用を含む各文について、引用文献が新しい版の内容を本当に述べているかを確かめます。特に動詞に注意してください。found、showed、argued、emphasized、suggestedなどです。
- 言い換えで消えた分野の用語を元に戻します。名前のある概念こそが、レビューを先行研究とつなぐものです。
- 数量や範囲を表す言葉(「several hundred」「at scale」「without overburdening instructors」)を比較します。
- 提出前に、所属機関やジャーナルのAIポリシーを確認します。
各手順の詳細は、AIを活用した研究での引用の習慣と学術用語をそのまま保つ方法のガイドで解説しています。
結論
検出の面では、今回の実行は文献レビューの書き手が望むとおりの結果でした。判定された8文は人間の文として読まれる8文になり、引用は手つかずで残りました。意味の面では、5か所ほどの表現に絞った手直しが必要な原稿になりました。手直しさえきちんと行えば、妥当な取引だと言えます。
Academic Humanizerは、まさにその手直しのために設計されています。AI Detection Reportでは元の各文と書き直しが並べて表示されるため、二つの段落を目で見比べる代わりに、帰属とヘッジ表現を一対ずつ確認できます。
あなたのアイデアを、AIの痕跡なしで
下書きを貼り付けると、AI検出ツールが指摘する文を表示し、その文だけをHumanizerで書き直します。
Humanizerを無料で試す続けて読む
 事例
AIで書いた助成金申請書はバレる?実地テストと必要な確認
AIで下書きした助成金申請書の概要で、AI判定5票が0票になりました。一方で書き換えにより3年の期間が消え、"innovative" が加わりました。確認の工程が重要です。
記事を読む
 事例
方法セクションのAI検出:Humanizerが手を付けなかった理由
AIで下書きした論文の方法セクションでは検出モデルの判定が3対2に割れ、全文が判定保留となり、Humanizer v2は何も変更しませんでした。その理由を解説します。
記事を読む
 事例
非ネイティブの英語はAI判定される?実際の文章でテスト
非ネイティブの研究者が自分で書いた、定型的でも人間らしい考察の段落。五つの検出モデルのうち四つが人間と判定し、Humanizer v2は手を付けませんでした。
記事を読む