

문헌 검토 AI 탐지: 인용까지 확인한 실제 테스트
AI로 초안을 쓴 문헌 검토 문단을 Humanizer v2로 처리했습니다. 인용은 모두 그대로 남았지만, 인용에 붙은 주장 일부는 달라졌습니다.
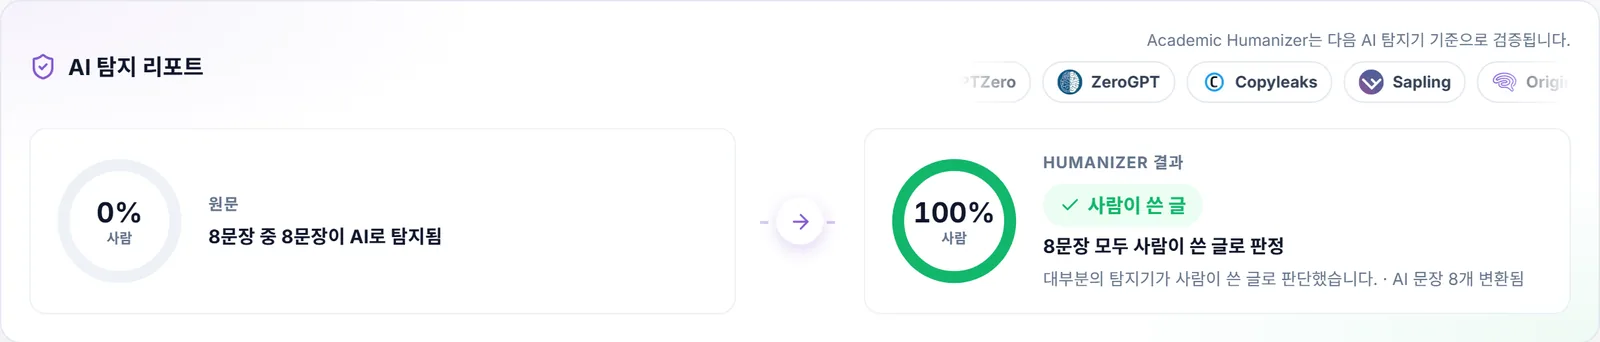
AI 탐지기는 AI로 초안을 쓴 문헌 검토를 잡아낼까요? 저희 테스트에서는 예외 없이 잡아냈습니다. 초안에서 탐지 모델 다섯 개가 모두 AI로 판정했고 여덟 문장이 모두 표시되었습니다. 교육학 연구의 문단이었고, Humanizer v2로 처리했습니다. 실행 후에는 다섯 모델 중 넷이 사람으로 판정했고, 모든 문장이 사람이 쓴 글로 읽혔으며, 인용 묶음 네 개도 모두 온전히 남았습니다.
인용은 살아남았습니다. 하지만 인용에 붙은 주장 중 일부는 그대로 남지 않았고, 꼼꼼히 읽어 볼 부분은 바로 이것입니다.
문헌 검토 문장이 표시되는 이유
문헌 검토 문단은 모양이 뻔합니다. 분야가 성장하고 있고, 연구들은 효과를 보여 주며, 효과는 제각각이고, 최근의 한 갈래가 중요하며, 공백이 남아 있고, 연구가 필요하다는 흐름입니다. 언어 모델은 이 모양을 능숙하게 재현하고, 매번 같은 연결어로 꾸밉니다. 초안의 문장들은 "In recent years", "However", "For instance", "Moreover", "Despite these advances", "Consequently"로 시작했고, "garnered considerable attention"(상당한 주목을 받았다)과 "a pressing need"(시급한 필요)라는 표현도 썼습니다.
In recent years, the integration of formative assessment practices into higher education has garnered considerable attention from researchers and practitioners alike. Numerous studies have highlighted the potential of formative feedback to enhance student learning outcomes, foster self-regulated learning, and promote deeper engagement with course content (Black & Wiliam, 1998; Nicol & Macfarlane-Dick, 2006). However, the effectiveness of such practices is not uniform across contexts. For instance, Hattie and Timperley (2007) emphasized that the impact of feedback depends heavily on its focus, timing, and the extent to which it addresses the gap between current and desired performance. Moreover, recent scholarship has increasingly recognized the role of student feedback literacy in determining whether feedback is actually used (Carless & Boud, 2018). Despite these advances, a notable gap remains in understanding how large-enrollment courses can implement formative assessment at scale without overburdening instructors. This gap is particularly salient in the context of introductory STEM courses, where class sizes frequently exceed several hundred students. Consequently, there is a pressing need for research that examines scalable, technology-supported approaches to formative feedback in such settings.
테스트 실행의 실제 검사 결과입니다. 여덟 문장 모두 AI로 표시되었습니다."However, the effectiveness of such practices is not uniform across contexts"처럼 짧고 평이한 문장조차 표시되었습니다. 탐지기는 어휘뿐 아니라 문단의 리듬도 읽으며, 고르게 짜인 문장이 이어지면 각 문장이 AI 쪽으로 끌려갑니다.
실행 과정
- AI 신호 검사여덟 문장 중 여덟 문장이 표시되었고, 다섯 모델 모두 AI로 판정했습니다.
- 표시된 문장 고쳐 쓰기여덟 문장을 모두 고쳐 썼고, 인용은 새 문장마다 그대로 옮겨졌습니다.
- AI 탐지기로 재검사이제 여덟 문장 모두 사람이 쓴 글로 읽히며, 다섯 모델 중 넷이 사람으로 판정합니다.
- 결과 저장1,320자, 500자당 1크레딧, 올림 처리: 3크레딧.
- AI 초안 문단5개 중 5개
- Humanizer v2 결과5개 중 1개
인용은 살아남았을까?
전부, 한 글자도 빠짐없이 남았습니다. 문헌 검토에서는 이 점이 어디보다 중요합니다. 연도가 틀리거나 공저자가 빠지는 실수는 그 분야를 아는 심사자에게 신뢰를 잃게 만드는 종류의 오류이기 때문입니다.
| 인용 | 결과에 남았나? | 주변에서 바뀐 것 |
|---|---|---|
| Black & Wiliam, 1998 | 예, 변경 없음 | 뒷받침하는 주장에서 "potential"(가능성)이 "efficacy"(효능)로 바뀜 |
| Nicol & Macfarlane-Dick, 2006 | 예, 변경 없음 | 위와 같은 문장 |
| Hattie and Timperley (2007) | 예, 변경 없음 | "emphasized"(강조했다)가 "found"(발견했다)로, "addresses the gap"(격차를 해소한다)이 "highlights the gap"(격차를 드러낸다)으로 바뀜 |
| Carless & Boud, 2018 | 예, 변경 없음 | "feedback literacy"(피드백 리터러시)라는 용어가 빠짐 |
참고문헌은 안전합니다. 살펴봐야 할 곳은 귀속입니다. 인용이란 인용한 문헌이 내 문장이 말하는 바를 실제로 말한다는 약속입니다. 탐지기가 참고문헌 목록 자체를 표시했다면 다른 문제이며, 턴잇인이 참고문헌과 인용을 AI로 표시하는 이유에서 다룹니다.
완곡 표현은 어떻게 바뀌었나
문헌 검토에서 완곡 표현은 장식이 아닙니다. "highlighted the potential"(가능성을 강조했다)과 "shown the efficacy"(효능을 보여 주었다)는 근거에 대해 서로 다른 주장을 하며, 같은 분야의 독자는 어느 쪽을 택했는지 알아챕니다.
수정 전
Numerous studies have highlighted the potential of formative feedback to enhance student learning outcomes, foster self-regulated learning, and promote deeper engagement with course content (Black & Wiliam, 1998; Nicol & Macfarlane-Dick, 2006). For instance, Hattie and Timperley (2007) emphasized that the impact of feedback depends heavily on its focus, timing, and the extent to which it addresses the gap between current and desired performance. Moreover, recent scholarship has increasingly recognized the role of student feedback literacy in determining whether feedback is actually used (Carless & Boud, 2018).
수정 후
Many studies have shown the efficacy of formative feedback in improving student learning, facilitating self-regulated learning and enhancing students’ engagement with the course material (Black & Wiliam, 1998; Nicol & Macfarlane-Dick, 2006). Hattie and Timperley (2007), for example, found that the effectiveness of feedback varies based on its focus, timing, and whether it highlights the gap between current and desired performance. More recently, there has been a growing literature that links feedback effectiveness to the ability of students to interpret feedback (Carless & Boud, 2018).
심사자의 눈으로 읽으면 변경 사항은 세 가지로 나뉩니다.
- 더 강해진 주장. "highlighted the potential"이 "shown the efficacy"가 되었습니다. 초안의 표현이 더 신중했고, 연구 전반을 요약할 때는 보통 신중한 쪽이 더 안전합니다.
- 달라진 귀속 동사. Hattie와 Timperley의 논문은 피드백 모델을 세우는 리뷰 논문입니다. "emphasized"는 이에 맞지만 "found"는 실증 결과를 암시합니다. 또 격차를 "addresses"하는 피드백과 "highlights"하는 피드백은 다릅니다. 하나는 격차를 메우고, 다른 하나는 격차를 가리킬 뿐입니다.
- 사라진 용어. "student feedback literacy"는 Carless와 Boud를 대표하는 개념입니다. 고쳐 쓴 문장은 이를 학생들의 "ability to interpret feedback"(피드백을 해석하는 능력)으로 풀어 썼고, "whether feedback is actually used"(피드백이 실제로 활용되는지, 즉 수용)는 해석으로 바뀌었습니다. 이 논문을 인용하는 저자라면 원래 용어를 되살리고 싶을 것입니다.
연구 공백 문장에서 바뀐 것
마지막 세 문장이 문단의 논지를 담고 있습니다. 무엇이 빠져 있는지, 어디서 중요한지, 무엇이 필요한지입니다. 두 가지 세부 사항이 달라졌습니다.
- "class sizes frequently exceed several hundred students"(수강생이 수백 명을 넘는 경우가 많다)가 "many classes have over a hundred students"(백 명이 넘는 수업이 많다)로 바뀌었습니다. 사실관계가 약해진 것입니다. 연구 동기가 초대형 강의에 기대고 있다면 원래대로 되돌리세요.
- "how large-enrollment courses can implement formative assessment at scale without overburdening instructors"(대규모 강의에서 교수자에게 과도한 부담을 주지 않고 형성평가를 대규모로 시행하는 방법)가 "in large enrolling courses"에서의 시행에 관한 연구 부족으로 바뀌었습니다. 실제 공백인 교수자 업무 부담이라는 관점이 사라졌고, "large enrolling courses"라는 표현도 어색합니다.
아이러니한 점도 있습니다. 고쳐 쓴 문장에 "one crucial limitation"과 "significant differences"가 새로 들어갔는데, 꼼꼼한 편집자라면 덜어낼 단어들입니다. 특히 "significant"는 교육학 논문에서 통계적 주장으로 오해받을 수 있습니다. 그런데도 탐지기는 이 문장들을 사람이 쓴 글로 읽었습니다. 탐지 검사와 학술지의 문체 기준은 별개의 판단이라는 뜻입니다.
휴머나이징한 문헌 검토를 검토하는 순서
- 모든 인용을 참고문헌 관리 도구와 대조하세요. 저자, 연도, 구두점까지 확인합니다.
- 인용 문장마다 인용한 문헌이 새 버전의 내용을 실제로 말하는지 따져 보세요. 특히 found, showed, argued, emphasized, suggested 같은 동사에 주의하세요.
- 풀어 쓰는 과정에서 사라진 분야 용어를 되살리세요. 이름 붙은 개념이 내 문헌 검토를 기존 연구와 이어 줍니다.
- 수량과 범위를 나타내는 말("several hundred", "at scale", "without overburdening instructors")을 비교하세요.
- 제출 전에 소속 기관이나 학술지의 AI 정책을 확인하세요.
각 단계는 AI 활용 연구의 인용 습관과 학술 용어를 온전히 지키는 법에서 더 자세히 다룹니다.
정리하면
탐지 측면에서 이번 실행은 문헌 검토를 쓰는 사람이 원하는 대로 되었습니다. 표시된 여덟 문장이 모두 사람이 쓴 글로 읽혔고, 인용은 손대지 않은 채 남았습니다. 의미 측면에서는 다섯 개 정도의 표현을 집중적으로 손봐야 하는 초안이 나왔습니다. 그 손질만 거친다면 합리적인 교환입니다.
Academic Humanizer는 바로 그 손질을 중심으로 설계되었습니다. AI 탐지 리포트는 원문 문장과 고쳐 쓴 문장을 하나씩 나란히 보여 주므로, 두 문단을 눈으로 비교하는 대신 문장 쌍마다 귀속과 완곡 표현을 확인할 수 있습니다.
당신의 아이디어, AI 흔적 없이
초안을 붙여 넣으면 AI 탐지기가 어떤 문장을 표시하는지 보여 주고, 그 문장만 Humanizer로 다듬습니다.
Humanizer 무료로 써 보기이어서 읽기
 사례
연구비 제안서와 AI 글쓰기: 실제 테스트와 필요한 검토
AI로 쓴 연구비 제안서 요약에서 AI 판정 5표가 0표가 되었습니다. 하지만 3년 기간이 빠지고 "innovative"가 추가되었습니다. 검토 단계가 중요합니다.
글 읽기
 사례
연구 방법 섹션 AI 탐지: Humanizer가 손대지 않은 이유
AI로 초안을 쓴 연구 방법 섹션에서 탐지기 판정이 3대 2로 갈렸고, 모든 문장이 판정 불가였으며, Humanizer v2는 아무것도 바꾸지 않았습니다. 그 이유를 설명합니다.
글 읽기
 사례
AI 탐지기는 비원어민 영어를 AI로 판정할까? 실제 테스트
비원어민 영어 연구자가 직접 쓴, 정형화되었지만 사람이 쓴 고찰 문단입니다. 탐지 모델 다섯 중 넷이 사람 글로 판정했고, Humanizer v2는 그대로 두었습니다.
글 읽기